Generador de Face in Hole con IA
Explora un flujo de trabajo relacionado para crear imágenes de face-in-hole.


Cargando historial…
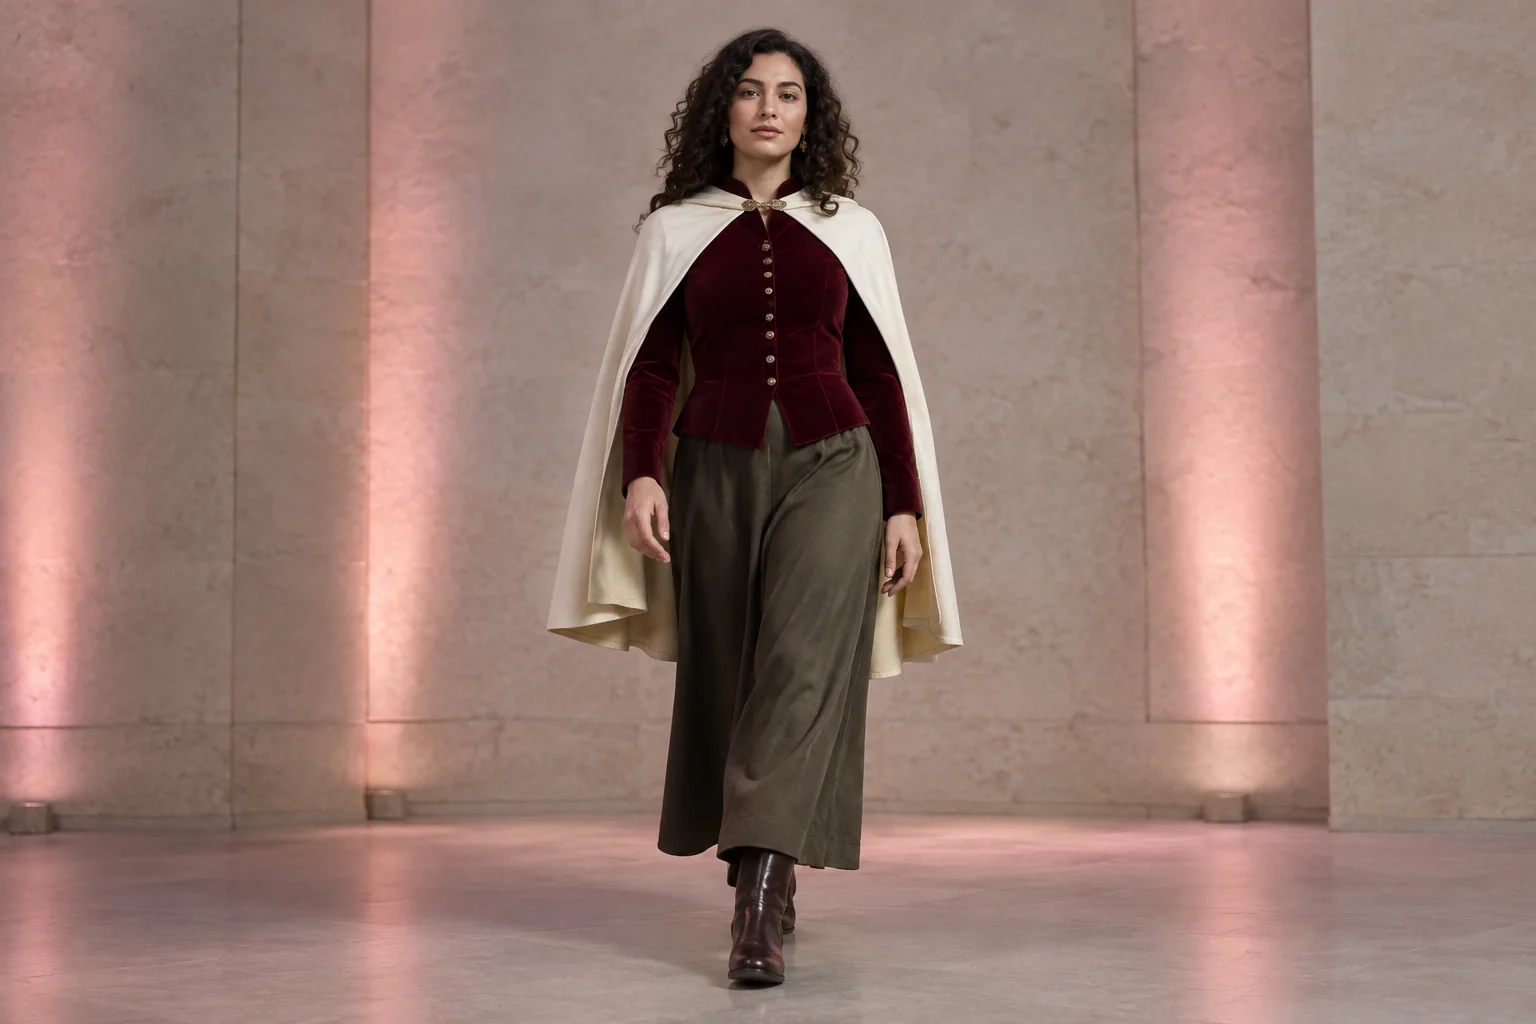
El Generador de video con IA Ramalama te permite planificar un concepto breve de entrada con vestuario en faceinhole.app, mediante texto a video o una imagen inicial. Esta guía adopta un enfoque protagonizado por un retrato: una mujer adulta de cabello oscuro y rizado, chaqueta de terciopelo burdeos y capa color marfil sobre los hombros da un único paso medido hacia delante frente a paredes de piedra clara y suaves focos de luz rosa. Mantén el rostro visible, la silueta del atuendo despejada y el movimiento moderado. Selecciona Seedance 2.5, escribe un prompt distinto para el modo que elijas y consulta en pantalla la información actual sobre disponibilidad del modelo y créditos antes de enviar.
Basa el concepto en una sola mujer adulta. Decide si vas a crear solo a partir de texto o si partirás de una imagen de referencia. Mantén el rostro visible y planifica una composición de cuerpo entero con márgenes amplios, para que el atuendo y los pies tengan espacio en el encuadre.
Elige texto a video o el flujo de trabajo con una imagen inicial y luego selecciona Seedance 2.5 si está disponible para ti. Consulta en pantalla la información actual sobre disponibilidad y créditos antes de continuar. Envía únicamente la entrada permitida por el modo que hayas seleccionado.
Usa el prompt de generación para texto a video; no requiere subir nada. Usa el prompt de edición solo con una imagen inicial y pídele que conserve los rasgos visibles de la referencia mientras añade una caminata sencilla y lenta. Evita combinar los dos prompts o añadir un segundo sujeto.
Envía la tarea con el modo elegido y consulta su estado en Historial, donde se registran las tareas. Cuando el resultado esté disponible, evalúa la visibilidad del rostro, el contorno del atuendo, los pies y el paso hacia delante, moderado. Si haces cambios, ajusta el prompt o la referencia de forma deliberada; no des por garantizada una identidad o un movimiento exactos.
Es más fácil planificar una entrada protagonizada por un retrato cuando el plano tiene una sola acción clara. En este caso, el sujeto da un paso medido en lugar de realizar una caminata compleja. Las paredes de piedra clara y los suaves focos de luz rosa ofrecen un entorno sencillo, mientras que la capa y la chaqueta crean una silueta distintiva. El objetivo es proporcionar al modo que elijas una descripción precisa, no garantizar un movimiento o una identidad exactos.
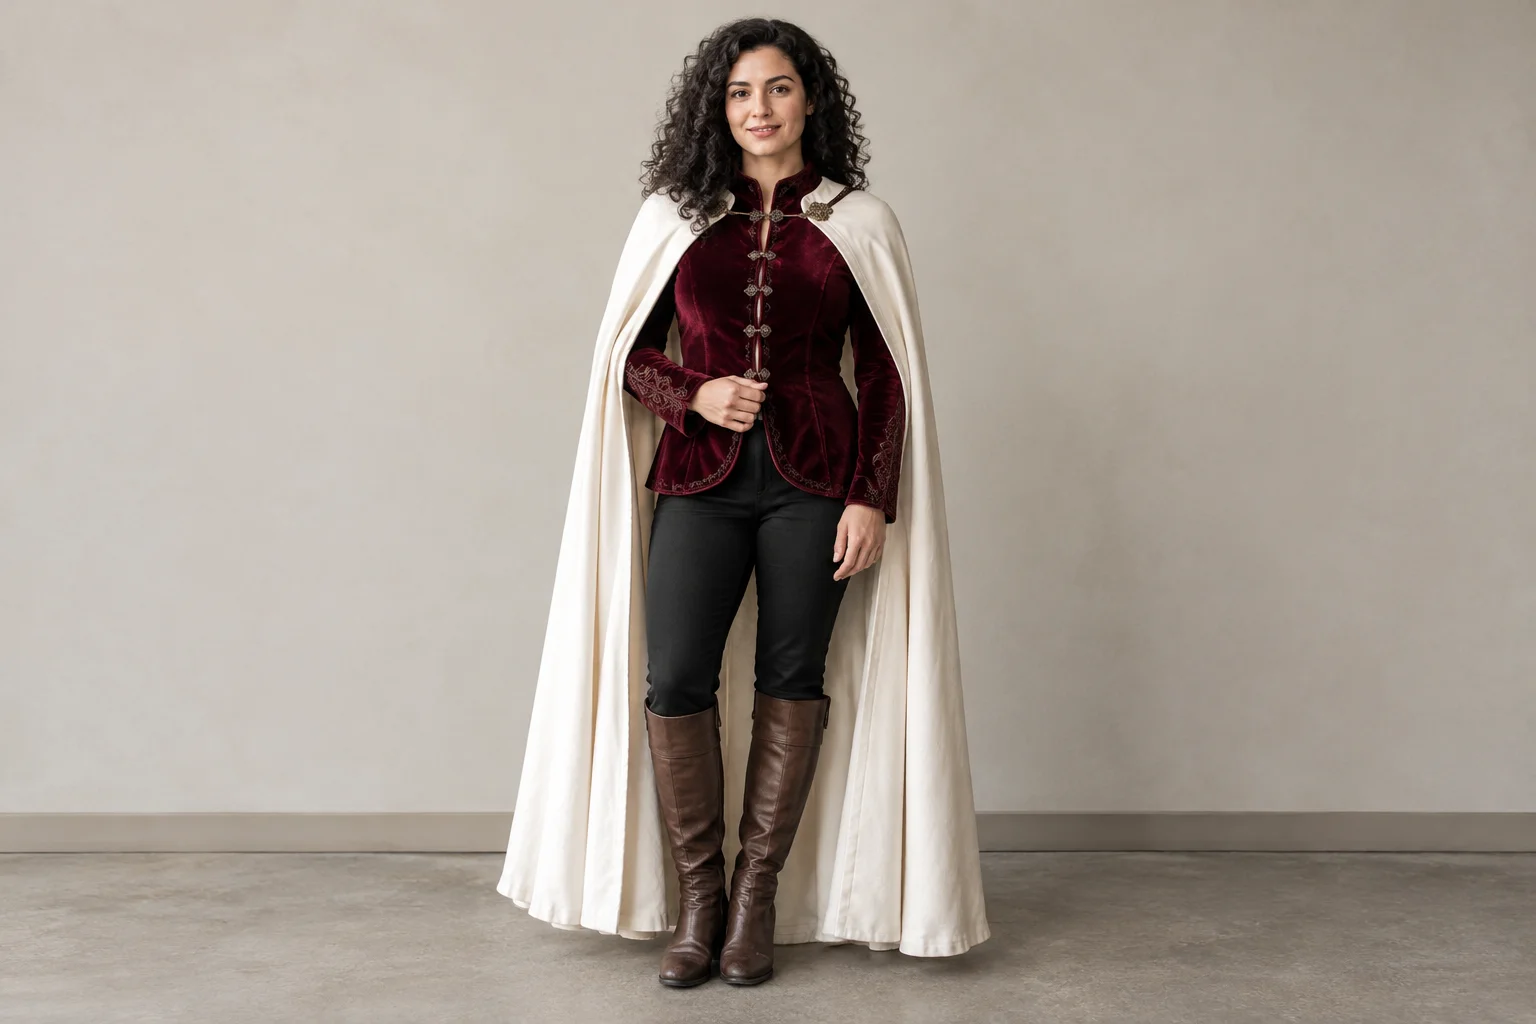
Usa texto a video cuando quieras describir con palabras al sujeto, el atuendo, el entorno, el encuadre y la acción; este modo no requiere subir nada. Elige la opción de una imagen inicial cuando tengas un retrato de referencia adecuado para proporcionar. Cada modo acepta únicamente la entrada permitida, así que no des por hecho que texto a video también admite una imagen ni que la opción de imagen inicial acepta varias imágenes. Para la referencia, es preferible un retrato de cuerpo entero, de frente, con luz uniforme, una postura relajada y espacio suficiente para ver los pies y la ropa.
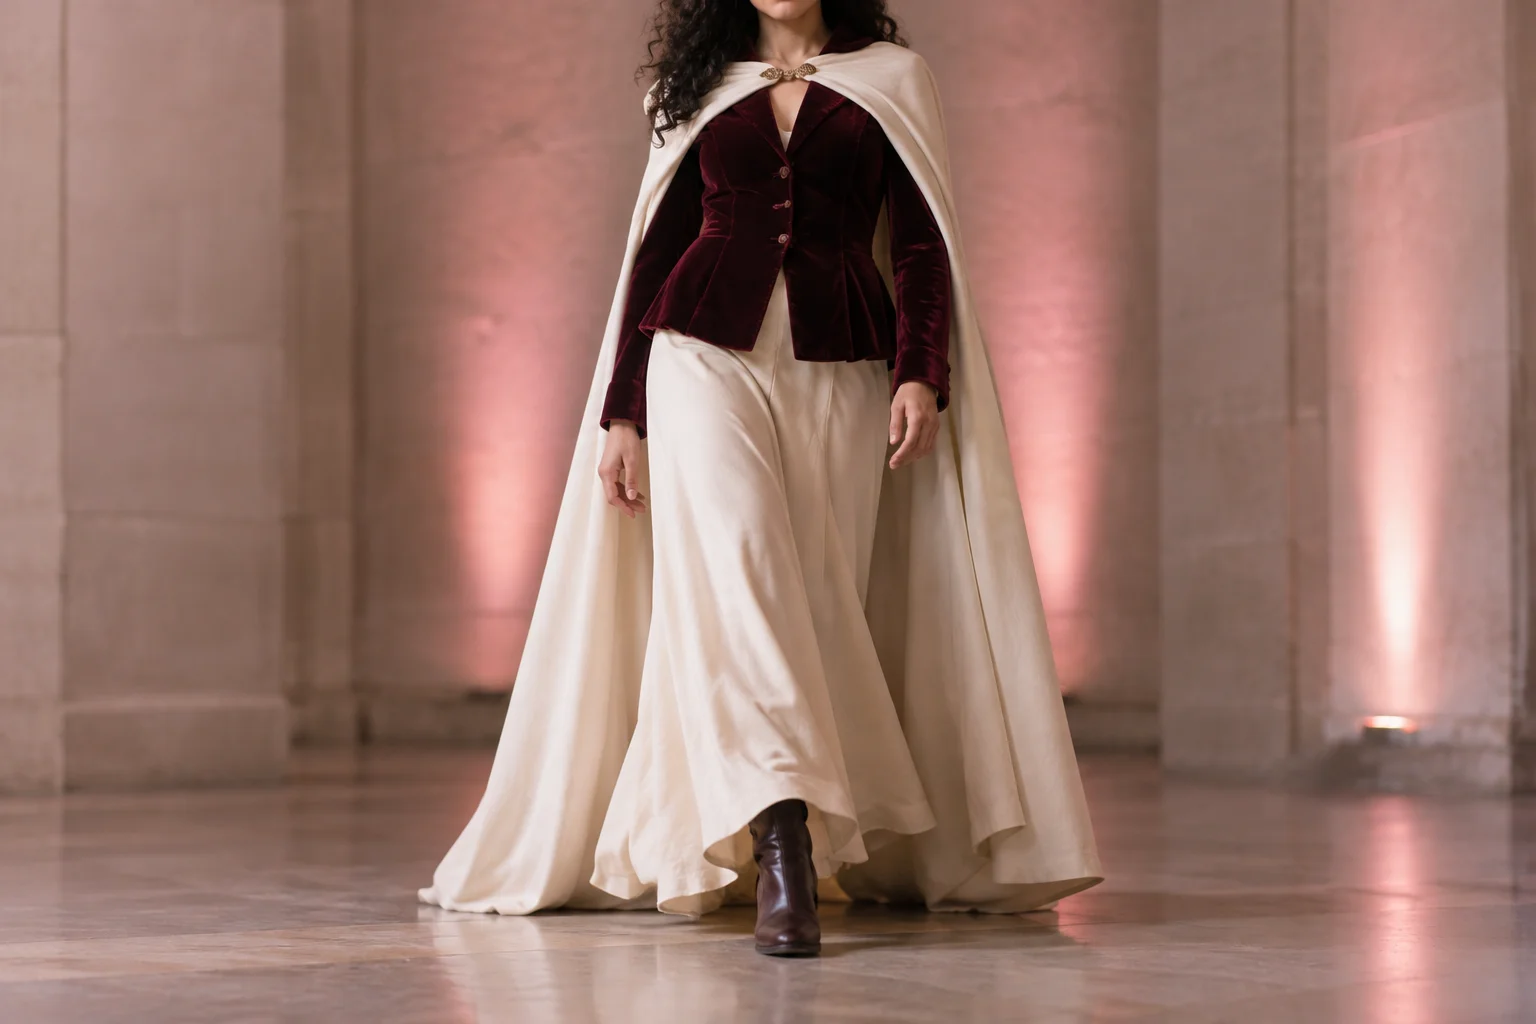
Las prioridades son que el rostro esté visible y que la silueta del atuendo no se vea recargada. Describe la posición de la cámara y un único paso, y luego mantén sobrios el entorno y la iluminación. Si algún detalle es importante, especifícalo: los pies completos dentro del encuadre, los bordes de la capa bien definidos, una expresión serena y ninguna persona ni accesorio adicional. El movimiento y el parecido no están garantizados, así que considera el prompt como una guía para un concepto y revisa el resultado en lugar de dar por sentado que todos los detalles serán exactos.
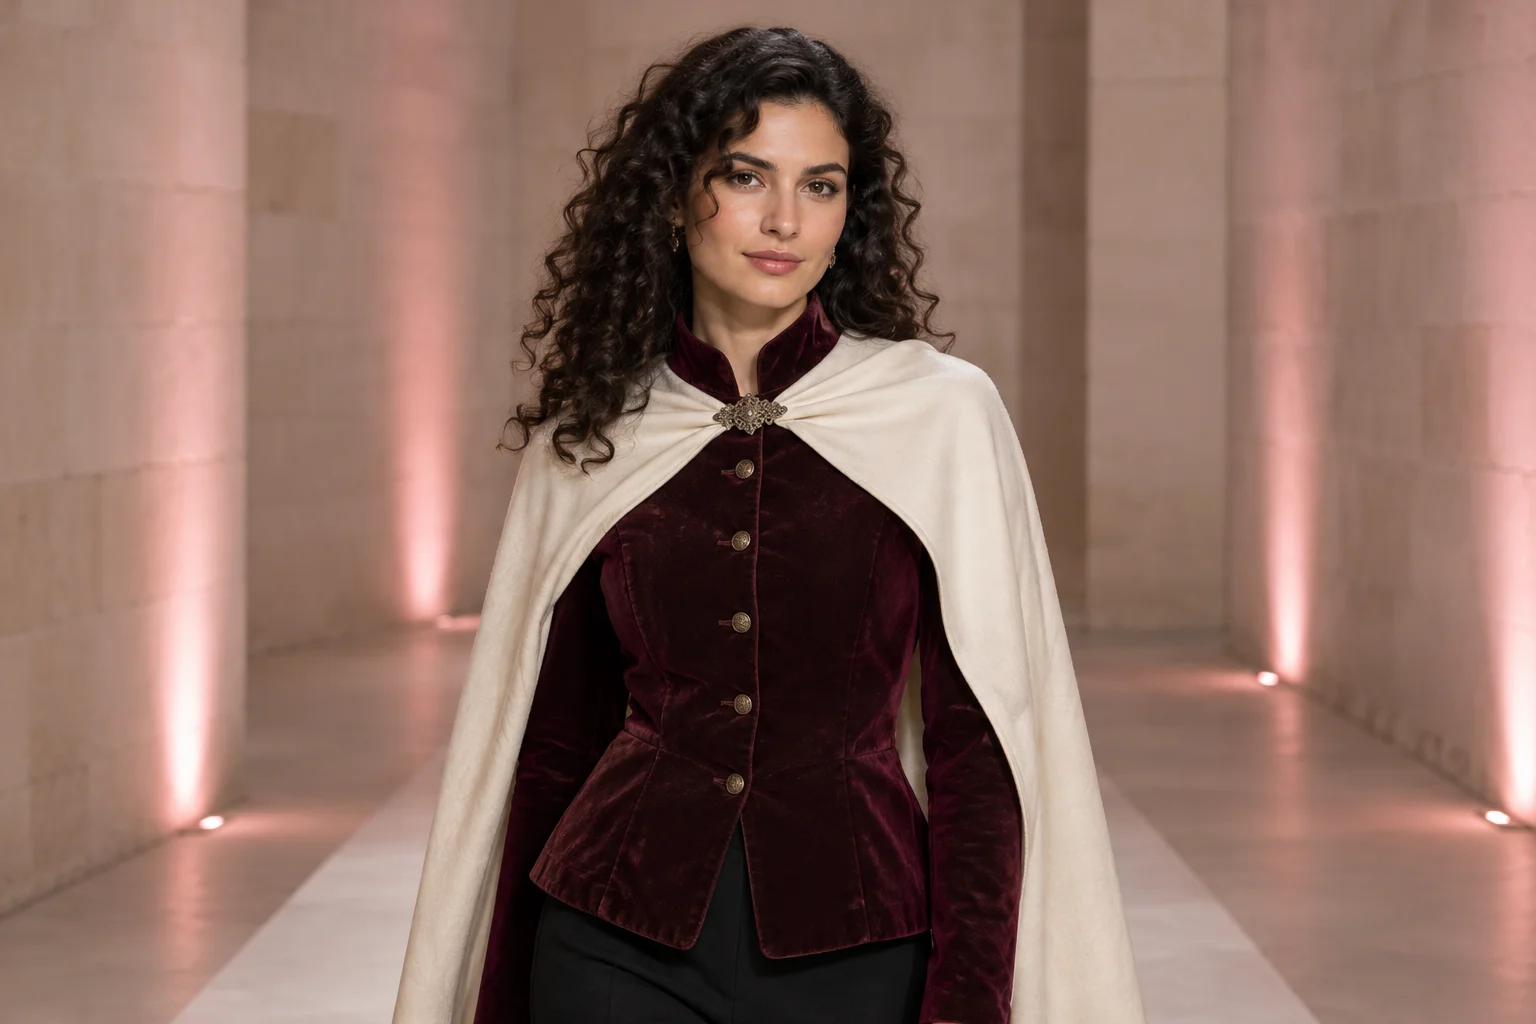
Selecciona Seedance 2.5 entre los modelos disponibles y consulta en pantalla la información actual sobre disponibilidad del modelo y créditos antes de enviar. Los requisitos de acceso y créditos pueden cambiar, así que fíate de lo que muestra la página en ese momento y no de un precio o una cuota supuestos. El tiempo de finalización puede variar; consulta el estado de la tarea que aparece en la interfaz. Historial registra las tareas, por lo que es el lugar indicado para consultar el trabajo enviado.
Observa cómo el rostro de la intérprete permanece visible mientras la capa morada se abre durante un baile con vestuario. Para tu entrada protagonizada por un retrato, simplifica el movimiento a un único paso medido hacia delante.
Es la opción de generación de video que se trata en esta guía de faceinhole.app. La página se centra en crear un concepto de entrada con vestuario protagonizada por un retrato, con un solo sujeto, el rostro visible y un paso medido.
Elige texto a video o una imagen inicial, selecciona Seedance 2.5 si está disponible y usa el prompt correspondiente a ese modo. Consulta en pantalla la información actual sobre disponibilidad y créditos, envía la tarea y luego síguela en Historial.
No para texto a video; esa opción usa un prompt escrito y no requiere subir nada. La otra opción usa una imagen inicial. Cada modo solo permite enviar las entradas admitidas.
Consulta en pantalla la información actual sobre créditos y disponibilidad del modelo antes de enviar. Esta guía no indica ningún precio, cuota gratuita ni acceso garantizado, ya que esos detalles pueden depender de la oferta vigente.
Aquí no se garantiza un tiempo de finalización fijo. Consulta el estado de la tarea en la interfaz y usa Historial para hacer seguimiento de las tareas enviadas.
No se garantizan una identidad ni un movimiento exactos. Especifica bien el prompt, usa una referencia clara si eliges la opción de imagen inicial y revisa el resultado para comprobar que los detalles del rostro estén visibles, los bordes de la tela se distingan y el movimiento sencillo previsto esté presente.
Explora un flujo de trabajo relacionado para crear imágenes de face-in-hole.
Descubre otro concepto de imagen centrado en los disfraces.
Explora otro entorno y concepto de video con IA.
Explora herramientas de video y guías relacionadas.
faceinhole.app · Actualizado