Gerador de Face in Hole com IA
Explore um fluxo de trabalho relacionado para imagens de face in hole.


Carregando histórico…
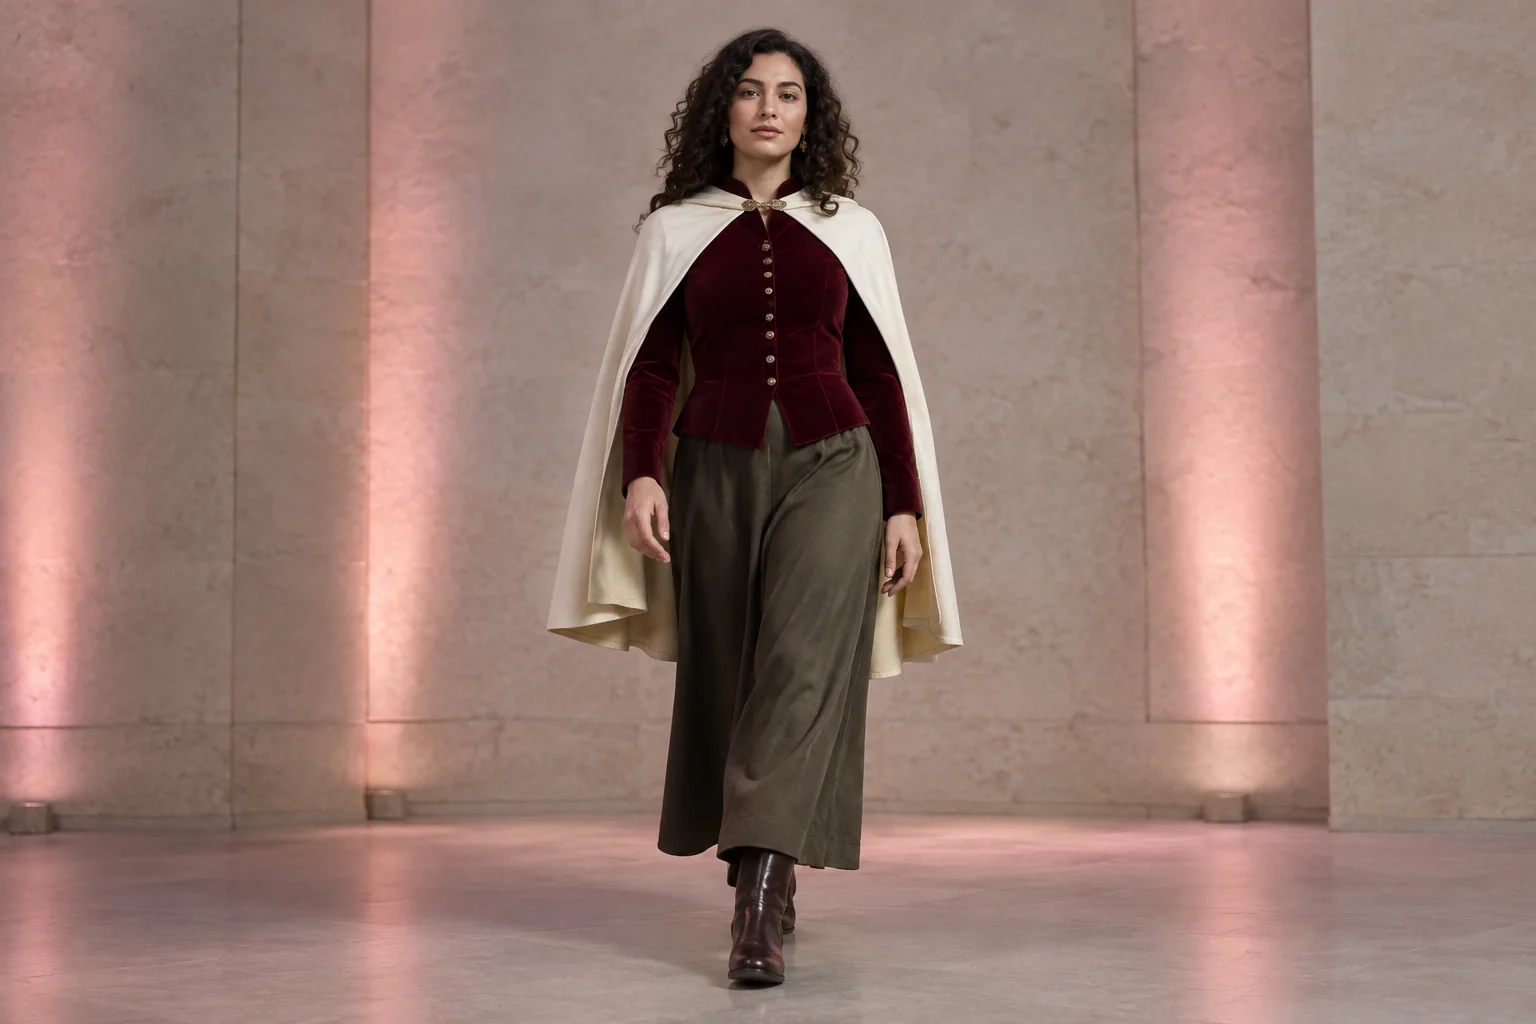
O Gerador de vídeos Ramalama AI permite planejar um conceito curto de entrada com figurino em faceinhole.app, usando texto para vídeo ou uma imagem inicial. Este guia adota uma abordagem com o retrato em destaque: uma mulher adulta de cabelos escuros cacheados, uma jaqueta de veludo bordô e uma capa curta marfim sobre os ombros dá um passo medido à frente diante de paredes de pedra clara e refletores rosa suaves. Mantenha o rosto visível, a silhueta do traje desobstruída e o movimento discreto. Selecione Seedance 2.5, escreva um prompt separado para o modo escolhido e confira as informações atuais de acesso ao modelo e de créditos exibidas na tela antes de enviar.
Desenvolva o conceito em torno de uma mulher adulta. Decida se vai criar apenas com texto ou começar com uma imagem de referência. Mantenha o rosto visível e planeje uma composição de corpo inteiro com margens amplas para que o traje e os pés tenham espaço no enquadramento.
Escolha texto para vídeo ou o fluxo de trabalho com uma imagem inicial e, em seguida, selecione Seedance 2.5, se estiver disponível para você. Confira as informações atuais de acesso e créditos exibidas na tela antes de continuar. Envie apenas o tipo de entrada permitido pelo modo selecionado.
Use o prompt de geração para texto para vídeo; não é necessário enviar uma imagem. Use o prompt de edição apenas com uma imagem inicial e indique que os elementos visíveis da referência devem ser preservados, adicionando uma caminhada simples e lenta. Evite combinar os dois prompts ou adicionar uma segunda pessoa.
Envie o modo escolhido e confira o status em Histórico, onde as tarefas são acompanhadas. Quando o resultado estiver disponível, avalie a visibilidade do rosto, o contorno do traje, os pés e o passo à frente contido. Se fizer ajustes, altere o prompt ou a referência de forma deliberada; não pressuponha identidade ou movimento exatos.
É mais fácil planejar uma entrada com o retrato em destaque quando a cena tem uma ação clara. Aqui, a pessoa dá um passo medido em vez de fazer uma caminhada complexa. As paredes de pedra clara e os refletores rosa suaves criam um cenário simples, enquanto a capa e a jaqueta formam uma silhueta distinta. O objetivo é oferecer ao modo escolhido uma descrição objetiva, não prometer um movimento ou resultado de identidade exatos.
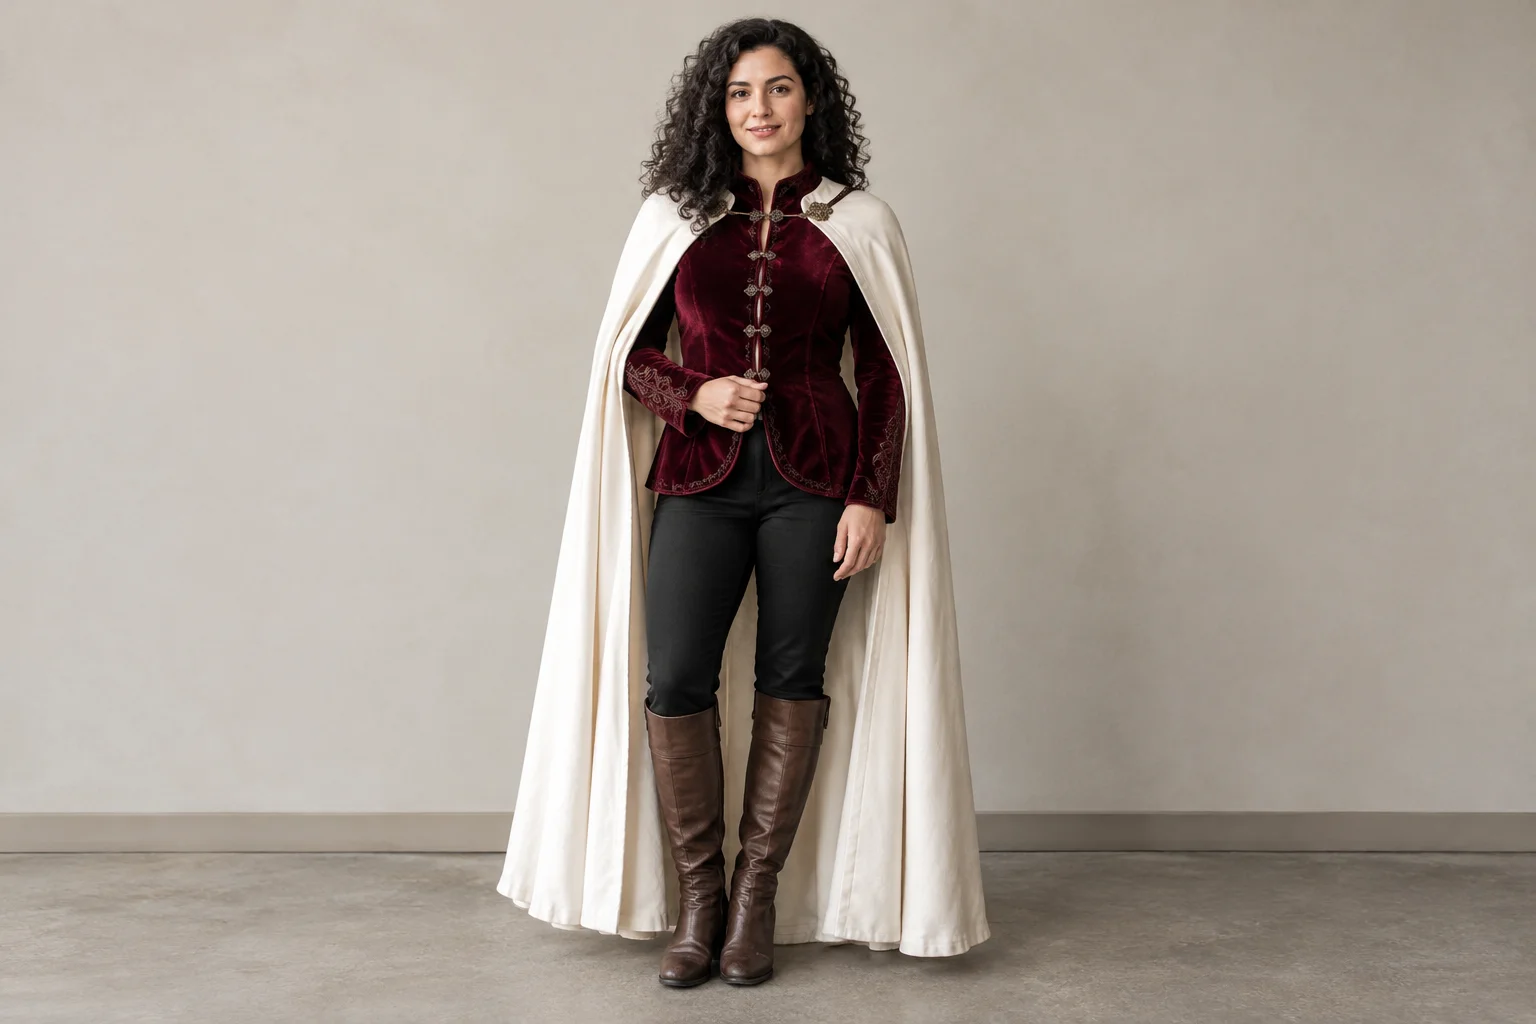
Use texto para vídeo quando quiser descrever com palavras a pessoa, o traje, o cenário, o enquadramento e a ação; esse modo não requer o envio de imagens. Use o fluxo com uma imagem inicial quando tiver um retrato de referência adequado para fornecer. Cada modo aceita apenas as entradas permitidas; portanto, não presuma que texto para vídeo também aceite uma imagem ou que o fluxo com imagem inicial aceite várias imagens. Para uma referência, prefira um retrato de corpo inteiro, de frente, com iluminação uniforme, pose descontraída e espaço suficiente para ver os pés e as roupas.
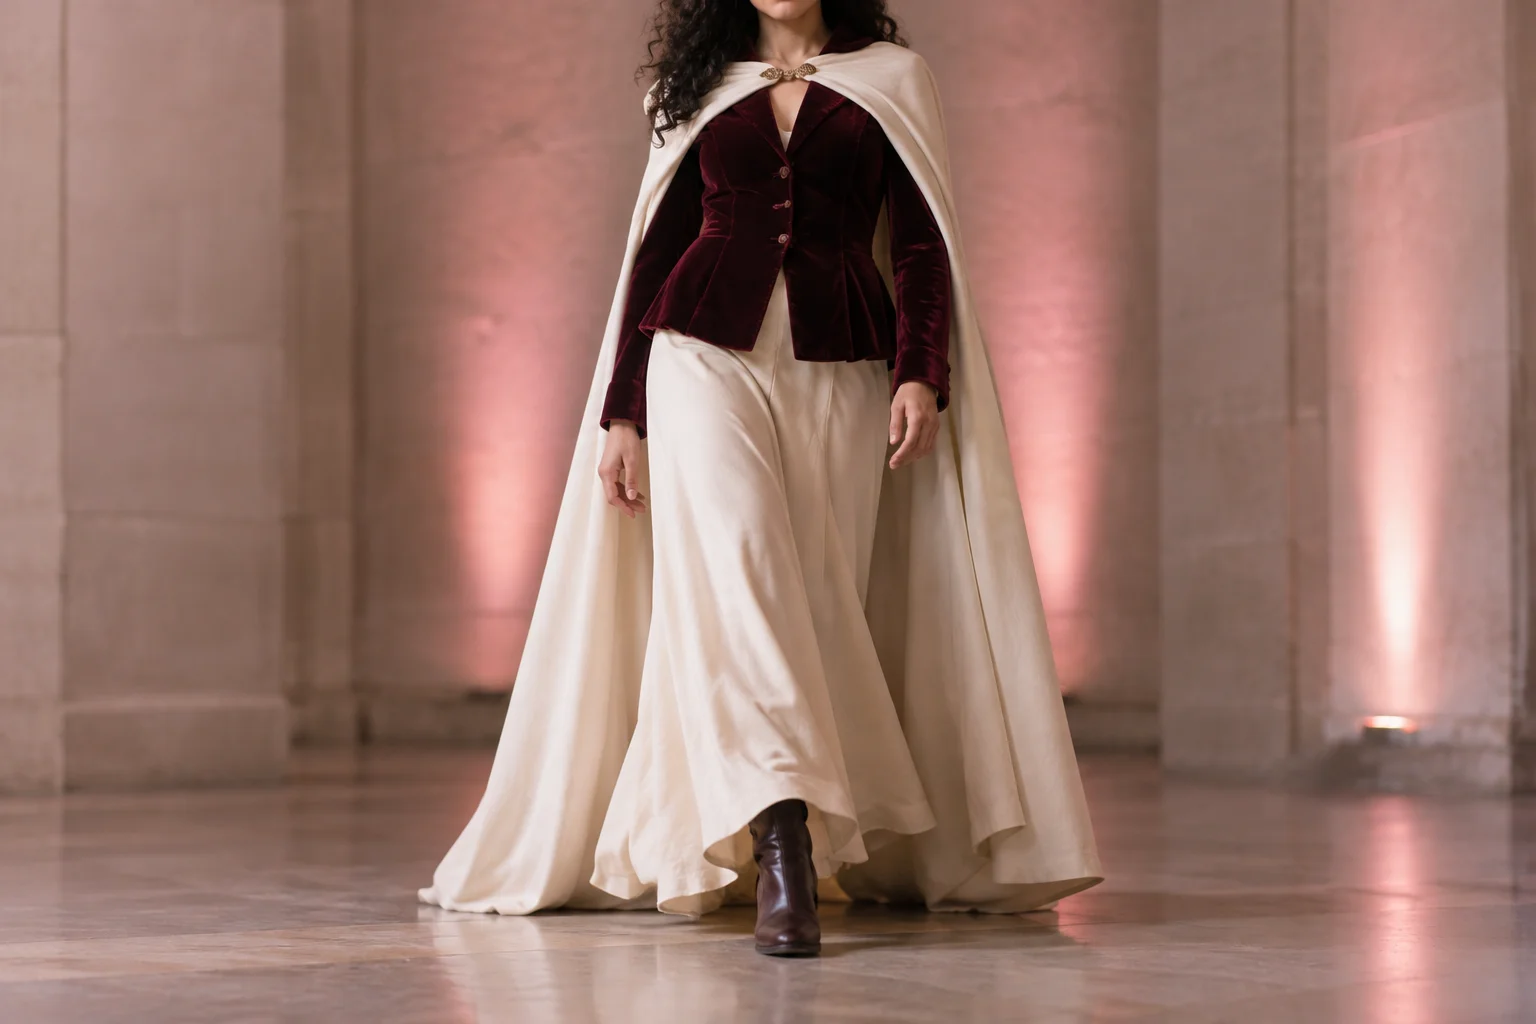
As prioridades são manter o rosto visível e a silhueta do traje desobstruída. Descreva a posição da câmera e um único passo, mantendo o cenário e a iluminação discretos. Se algum detalhe for importante, especifique-o: pés inteiros no enquadramento, bordas da capa nítidas, expressão serena e nenhuma pessoa ou objeto adicional. O movimento e a semelhança não são garantidos; portanto, trate o prompt como orientação para um conceito e revise o resultado, sem presumir que todos os detalhes serão exatos.
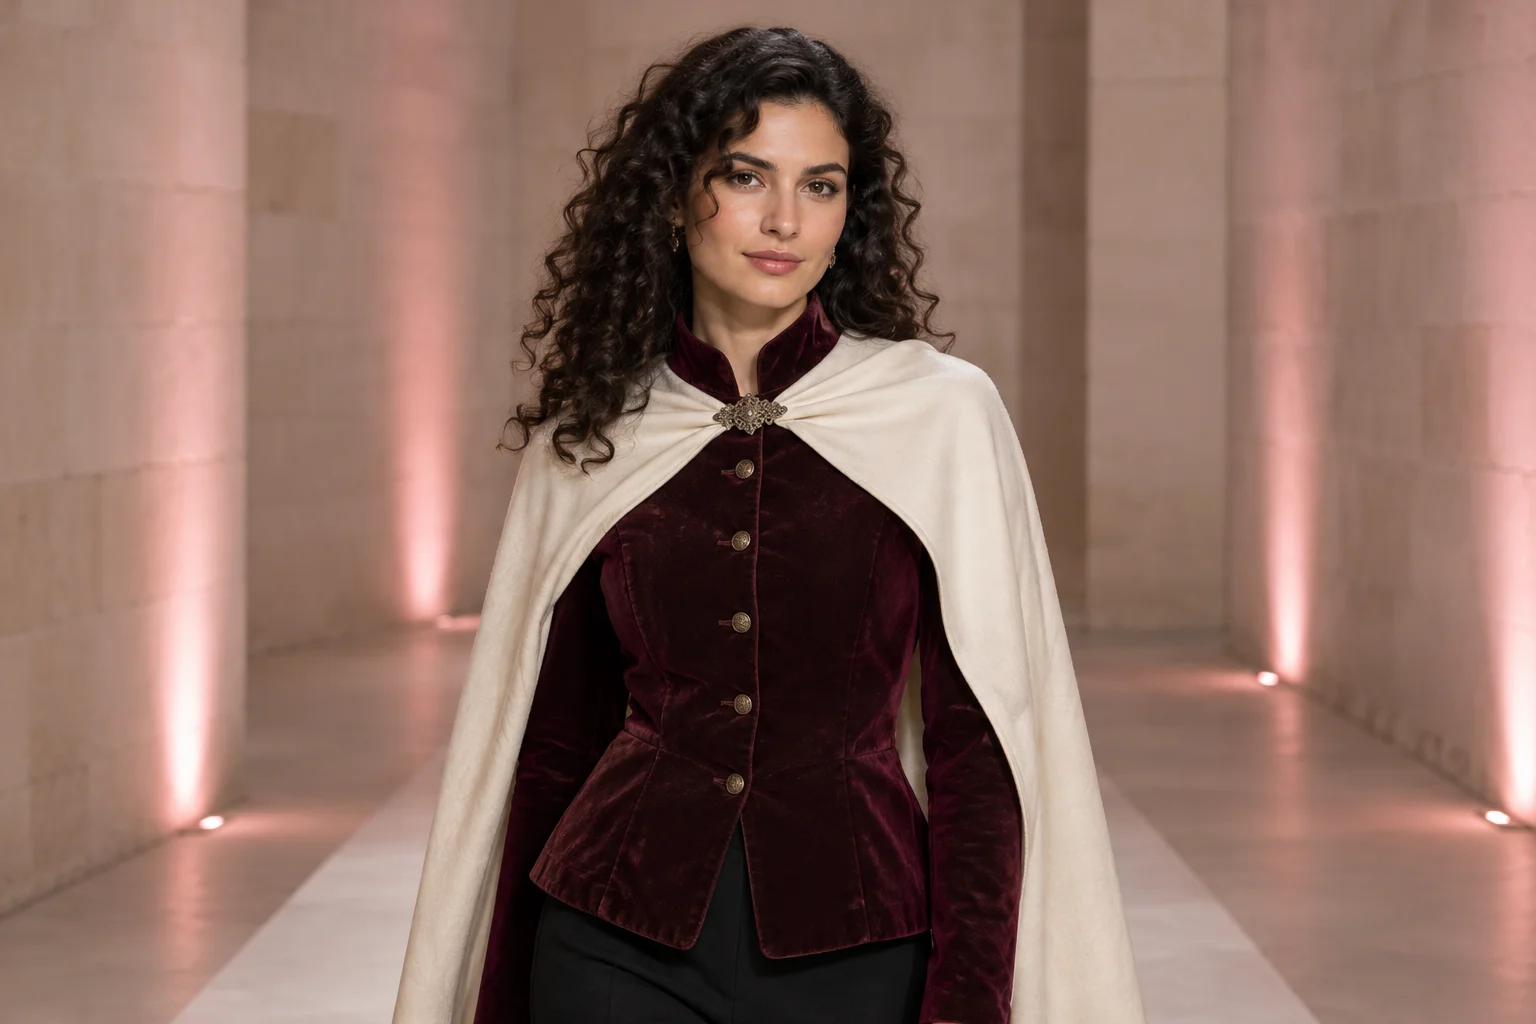
Selecione Seedance 2.5 nas opções de modelos disponíveis e, em seguida, confira as informações atuais de acesso ao modelo e de créditos na tela antes de enviar. Os requisitos de acesso e créditos podem mudar; por isso, confie no que a página mostra agora, em vez de presumir um preço ou limite. O tempo de conclusão pode variar; consulte o status da tarefa exibido na interface. O Histórico acompanha as tarefas e é o lugar certo para verificar o trabalho enviado.
Observe como o rosto da artista permanece visível enquanto a capa roxa se abre durante uma dança com figurino. Para sua entrada em retrato, simplifique o movimento para um único passo medido à frente.
É a opção de geração de vídeos abordada neste guia de faceinhole.app. O foco prático da página é criar um conceito de entrada com figurino em destaque no retrato, com uma pessoa, rosto visível e um passo medido.
Escolha texto para vídeo ou uma imagem inicial, selecione Seedance 2.5, se estiver disponível, e use o prompt específico para esse modo. Confira na tela os dados atuais de acesso e créditos, envie e acompanhe a tarefa no Histórico.
Não para texto para vídeo; esse fluxo usa um prompt escrito e não requer o envio de imagens. O outro fluxo usa uma imagem inicial. Cada modo envia apenas as entradas permitidas.
Confira na tela as informações atuais de créditos e acesso ao modelo antes de enviar. Este guia não informa preço, cota gratuita nem acesso garantido, pois esses detalhes podem depender da oferta atual.
Não há um tempo fixo de conclusão prometido aqui. Confira o status da tarefa na interface e use o Histórico para acompanhar as tarefas enviadas.
A identidade e o movimento exatos não são garantidos. Seja específico no prompt, use uma referência nítida se escolher o fluxo com imagem inicial e revise o resultado para verificar se os detalhes do rosto estão visíveis, as bordas do tecido estão nítidas e o movimento simples pretendido foi realizado.
Explore um fluxo de trabalho relacionado para imagens de face in hole.
Veja outro conceito de imagem com foco em fantasias.
Explore outro cenário e conceito de vídeo com IA.
Explore ferramentas de vídeo e guias relacionados.
faceinhole.app · Atualizado